
Apache Hop概述
1. 从Kettle到Hop
Kettle被Hitachi Vantara接管后,社区版(CE)逐渐停止发布与更新(见上一章说明),Kettle的原班核心人马带着代码"另起炉灶",这就是Apache Hop。要理清两者的关系,先看一条时间线:
- 2001年:Matt Casters开始编写Kettle,各工具均以厨房用具命名(Spoon勺子、Pan煎锅、Kitchen厨房、Carte菜单)
- 2006年:Pentaho收购Kettle,更名为Pentaho Data Integration(PDI)
- 2017年:Pentaho被日立收购,纳入Hitachi Vantara旗下,社区版更新逐渐放缓
- 2019年底:Matt Casters联合原Kettle核心团队(Bart Maertens等)启动Hop项目
- 2020年9月:Hop代码捐献给Apache软件基金会,进入Apache孵化器
- 2022年初:Apache Hop毕业成为Apache顶级项目(TLP),本系列使用的Kettle 9.x正是它的同源代码
Hop与Kettle的关系可以概括为:Hop是由Kettle原作者团队从Kettle 9.x代码fork而来的开源继任者。核心概念几乎一一对应:
| Kettle/PDI | Apache Hop | 说明 |
|---|---|---|
| transformation(转换) | pipeline(管道) | 数据流 |
| job(作业) | workflow(工作流) | 步骤流/控制流 |
| step(步骤) | transform | 管道的基本单元 |
| job entry(作业项) | action(动作) | 工作流的基本单元 |
| Spoon | Hop GUI | 图形化设计工具 |
| Kitchen/Pan | hop-run | 命令行执行工具(Kitchen和Pan合并) |
| Carte | Hop Server | 轻量级Web服务器 |
| 数据库/文件资源库 | project+environment | 项目+环境(JSON元数据) |
Kettle的ktr/kjb工程可以通过Hop自带的Hop Import工具迁移为Hop的管道/工作流,老工程可以平滑过渡。
提示
选型建议:Pentaho CE已停更,存在安全隐患,新项目建议直接采用Apache Hop;存量Kettle项目可借助Hop Import逐步迁移。
2. Hop是什么
Apache Hop,全称Hop Orchestration Platform(Hop编排平台),是Apache软件基金会旗下的开源数据编排平台,一款脱胎于Kettle的ETL工具。Hop纯Java编写,可以在Window、Linux、Unix上运行,继承了Kettle的理念:通过图形化的界面描述你想做什么,而不是你想怎么做。
Hop中有两种脚本文件,pipeline和workflow,pipeline完成针对数据的基础转换(对应Kettle的transformation),workflow则完成整个工作流的控制(对应Kettle的job)。
Hop官网:https://hop.apache.org ,官方文档:Hop手册 ,本文编写时最新版本为2.19(2026年8月发布)。
3. Hop要点
3.1 工程存储方式
Kettle支持XML和资源库两种存储方式,Hop则只保留文件方式:所有元数据(管道、工作流、数据库连接、运行配置等)一律以JSON文件形式存储在项目(project)目录中,因此天然适合用Git进行版本管理。Kettle的数据库资源库在Hop中已被"项目+环境"机制取代(见5.8)。
3.2 pipeline和workflow区别
与Kettle中transformation和job的区别如出一辙:
- workflow是步骤流,pipeline是数据流。这是两者最大的区别。
- workflow的每一个action,必须等到前面的action执行完,后面的才会执行;而pipeline会一次性把所有transform全部启动(一个transform对应启动一个线程),然后数据流从第一个transform开始,一条记录、一条记录地流向最后的transform;
3.3 Hop的组成
Kettle的"四大件"在Hop中的对应关系如下: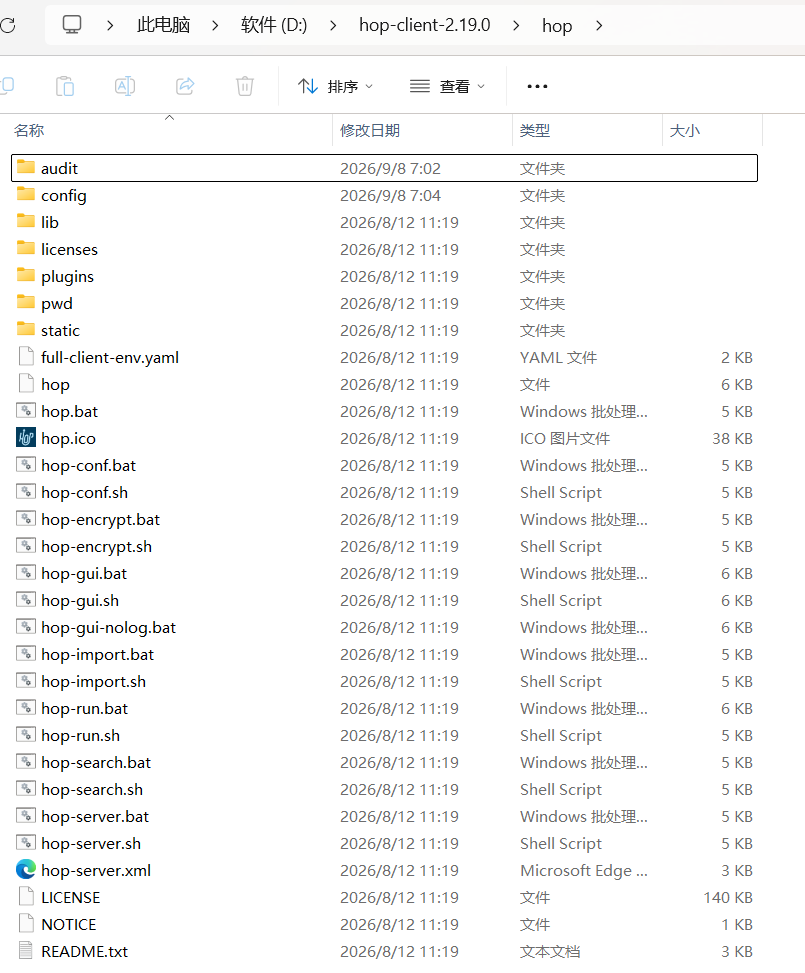
| Kettle | Hop | 说明 |
|---|---|---|
| Spoon.bat/sh | hop-gui.bat/sh | 图形化设计pipeline和workflow的UI工具 |
| Kitchen.bat/sh | hop-run.bat/sh | 命令行执行workflow |
| Pan.bat/sh | hop-run.bat/sh | 命令行执行pipeline,Hop中Kitchen/Pan合并为hop-run |
| Carte.bat/sh | hop-server.bat/sh | 轻量级Web服务器,用于远程执行和监控 |
此外Hop还附带一批命令行工具:hop-search(在项目元数据中全文搜索)、hop-import(从Kettle/PDI迁移工程)、hop-conf(管理项目、环境与运行配置)、hop-encrypt(密码加密解密)等。使用最多的仍然是Hop GUI。
4. Hop特点
- 免费开源:基于Apache License 2.0协议,可免费用于商业项目,没有Pentaho CE的停更与合规隐患
- 出身正统:由Kettle原作者及核心团队打造,完整继承Kettle的设计理念与使用习惯,老用户几乎零成本上手
- 跨平台:纯Java开发,Windows/Linux/macOS均可运行,绿色解压即用
- 元数据驱动:一切皆JSON元数据,配合项目/环境机制,天然适配Git版本管理与CI/CD流水线
- 云原生:官方提供Docker镜像,支持Kubernetes部署;pipeline还可以通过Apache Beam运行在Flink、Spark、Google Dataflow等引擎上
- 可扩展:插件化架构,支持自定义transform和action插件
- 界面友好:Hop GUI内置多语言支持,包括简体中文
5. Hop核心概念
与Kettle的核心概念一一对应,对照阅读上一章第6节效果更佳。
5.1 管道(pipeline)
管道对应Kettle的转换(transformation),负责数据的输入、转换、校验和输出等工作。管道由多个transform组成,各个transform使用hop链接。数据流动的最小单位是数据行(Row),数据流中流动的其实是缓存的行集(RowSet)。
5.2 transform
transform对应Kettle的步骤(step),是管道的基本组成单元,关键特性也一致:
- transform需要一个名字,在同一个管道范围内唯一
- 每个transform都会读、写数据行
- 大多数transform可以有多个输出hop,数据发送可设置为分发和复制
5.3 hop
hop就是带箭头的连线。在pipeline中,hop是transform之间的数据通路(本质是行集缓存);在workflow中,hop表示action之间的执行顺序,还可以设置跳转条件:无条件执行、前一个action成功才执行(绿勾)、失败才执行(红叉)。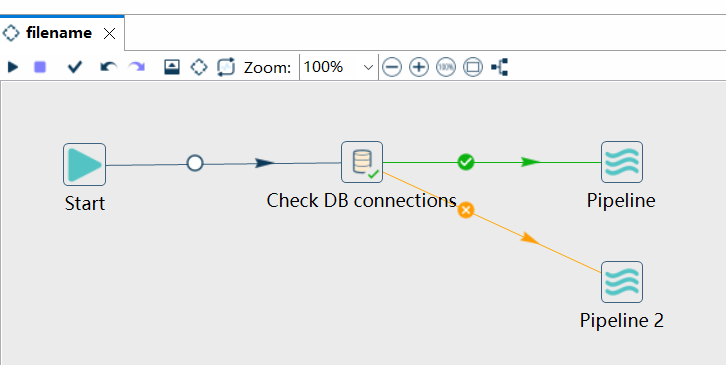
5.4 元数据
每个transform在输出数据行时都有对字段的描述,即数据行的元数据,包含名称、数据类型、格式、长度、精度、货币符号、小数点符号、分组符号等,与Kettle完全一致。更广义地,Hop本身就是元数据驱动的引擎,所有对象都以JSON元数据的形式存储。
5.5 数据类型
与Kettle一致:String、Number、Integer、BigNumber、Date、Boolean、Binary;Hop在此基础上增加了Timestamp(带纳秒精度的时间戳)、Internet Address(IP地址)等类型。
5.6 并行
pipeline内所有transform以独立线程并发执行,通过行集缓存协作,转换启动后所有transform同时启动,直到输入hop里不再有数据,全部transform中止,整个管道结束。需要串行调度时,就使用workflow。
5.7 工作流(workflow)
workflow对应Kettle的作业(job),负责整个工作流的编排控制:按依赖关系串行调度pipeline、脚本、邮件、文件传输等action,支持成功/失败分支、循环、条件判断等。因为pipeline以并行方式执行,所以必须存在一个串行的调度工具来编排它们,这就是workflow。
5.8 项目(project)与环境(environment)
项目和 环境 是Hop相对Kettle新增的核心概念,用于取代Kettle的资源库:
- 项目(project):一组相关元数据(管道、工作流、数据库连接、运行配置等)的集合,对应一个数据工程,以JSON文件存储,可纳入Git管理
- 环境(environment):同一个项目在不同环境(开发/测试/生产)下的变量配置集合,实现"一套代码、多环境运行"
- 运行配置(run configuration):定义pipeline/workflow在哪里、以什么方式执行(本地、Hop Server、Beam集群等)